format_list_bulleted Contenido
GPT-6 Cyber: OpenAI crea una IA que encuentra fallos y los explota
OpenAI ha presentado GPT-6 Cyber, un modelo especializado en seguridad informática que no se limita a señalar vulnerabilidades: es capaz de construir el ataque que las aprovecha para demostrar que son reales y, después, proponer el parche. La compañía lo ha clasificado como "Crítico" en ciberseguridad, el nivel más alto de su escala de riesgo, y de momento solo lo usa un grupo reducido de clientes aprobados.
Imagen: Europa Press
Los resultados que acompañan al lanzamiento son difíciles de ignorar: según OpenAI, el modelo encontró 81 vulnerabilidades graves y desconocidas en Firefox —Mozilla ya ha publicado correcciones— y, en el kernel de Linux, reprodujo 1.724 fallos y desarrolló exploits funcionales para 948 de ellos, más de cinco veces los 166 que logró el modelo anterior en la misma prueba.
security Lo esencial
bug_report Qué hace exactamente
La diferencia con un escáner de vulnerabilidades clásico es el doble uso. Un escáner marca posibles fallos; GPT-6 Cyber los convierte en una prueba de concepto: escribe el exploit, comprueba que funciona y documenta el impacto. Eso es lo que permite a los equipos de seguridad priorizar de verdad y a los mantenedores recibir informes con parche incluido, en lugar de avisos genéricos.
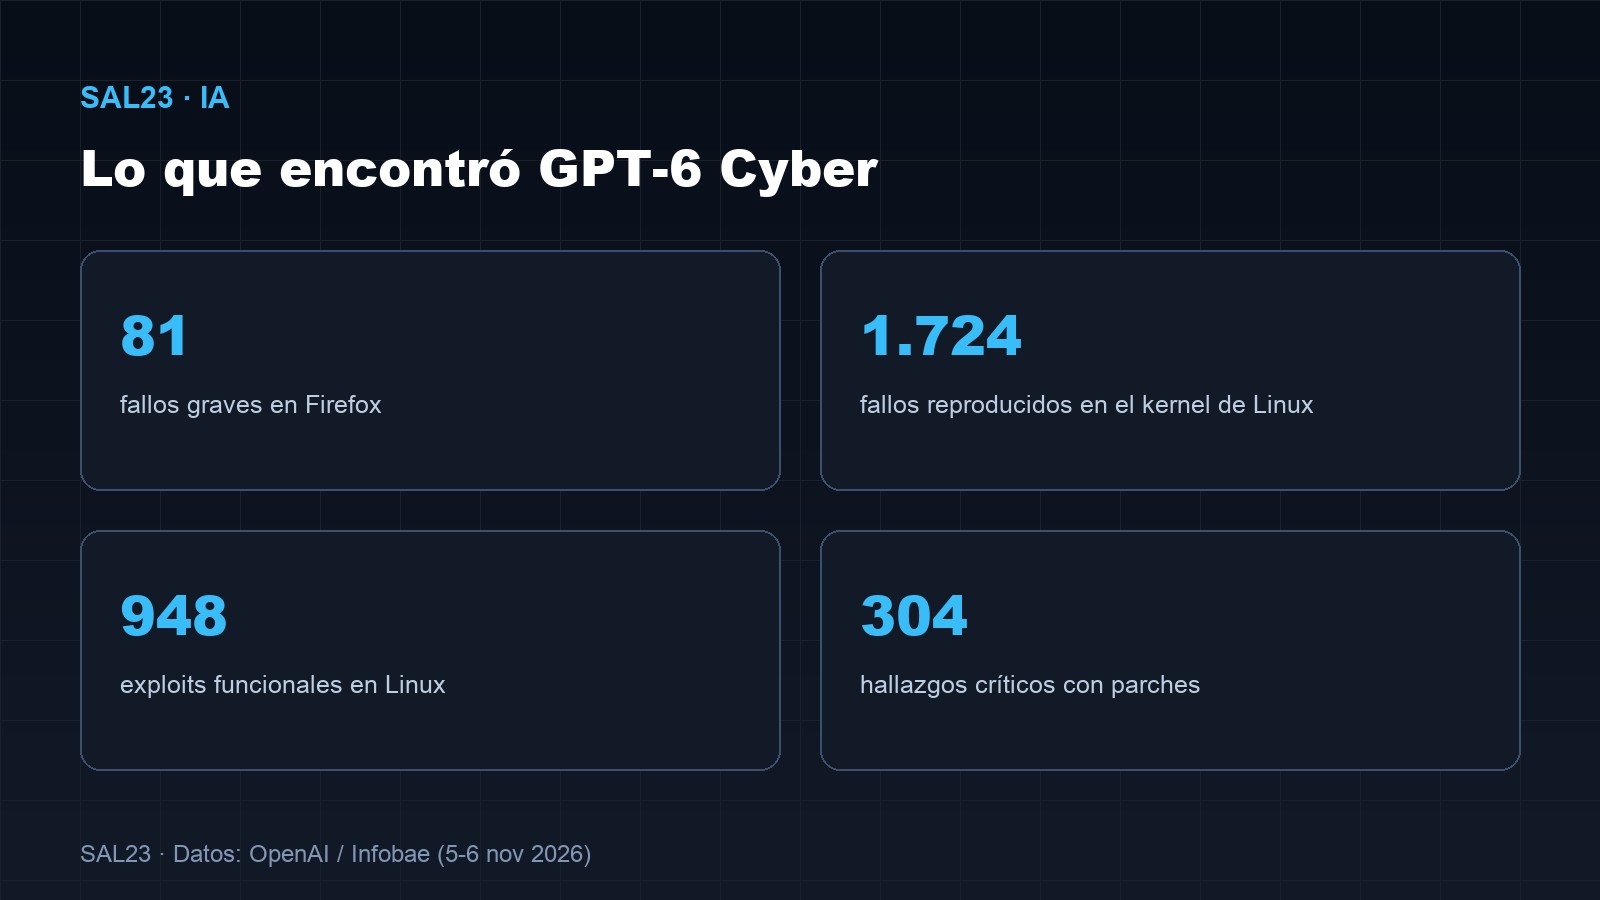
Imagen: SAL23 · Datos: OpenAI / Infobae (5-6 de noviembre de 2026)
 play_arrow
ondemand_video Vídeo: Cyber-AI · Ver en YouTube
Conviene subrayar que todas estas cifras son de OpenAI: no hay todavía una auditoría independiente que confirme los 81 fallos de Firefox ni los 948 exploits de Linux. La compañía publica su metodología en el system card, pero la verificación externa es la asignatura pendiente de todos los modelos que presumen de capacidades ofensivas.
En el caso de Firefox, OpenAI entregó los hallazgos a Mozilla, que los clasificó como de alta severidad y empezó a publicar correcciones poco después. En Linux, la compañía asegura que entregó 304 hallazgos críticos a los responsables del proyecto con parches propuestos. Son cifras que, si se confirman de forma independiente, cambiarían el ritmo al que se descubren fallos.
lock Un modelo de acceso cerrado
Por eso OpenAI no lo ha puesto a disposición de cualquiera. El modelo está en acceso limitado a clientes aprobados y verificados, con salvaguardas específicas y evaluaciones de seguridad publicadas en su Deployment Safety Hub. La clasificación "Crítico" implica que la compañía reconoce un riesgo real: el mismo sistema que ayuda a defender puede, en manos equivocadas, automatizar ataques.
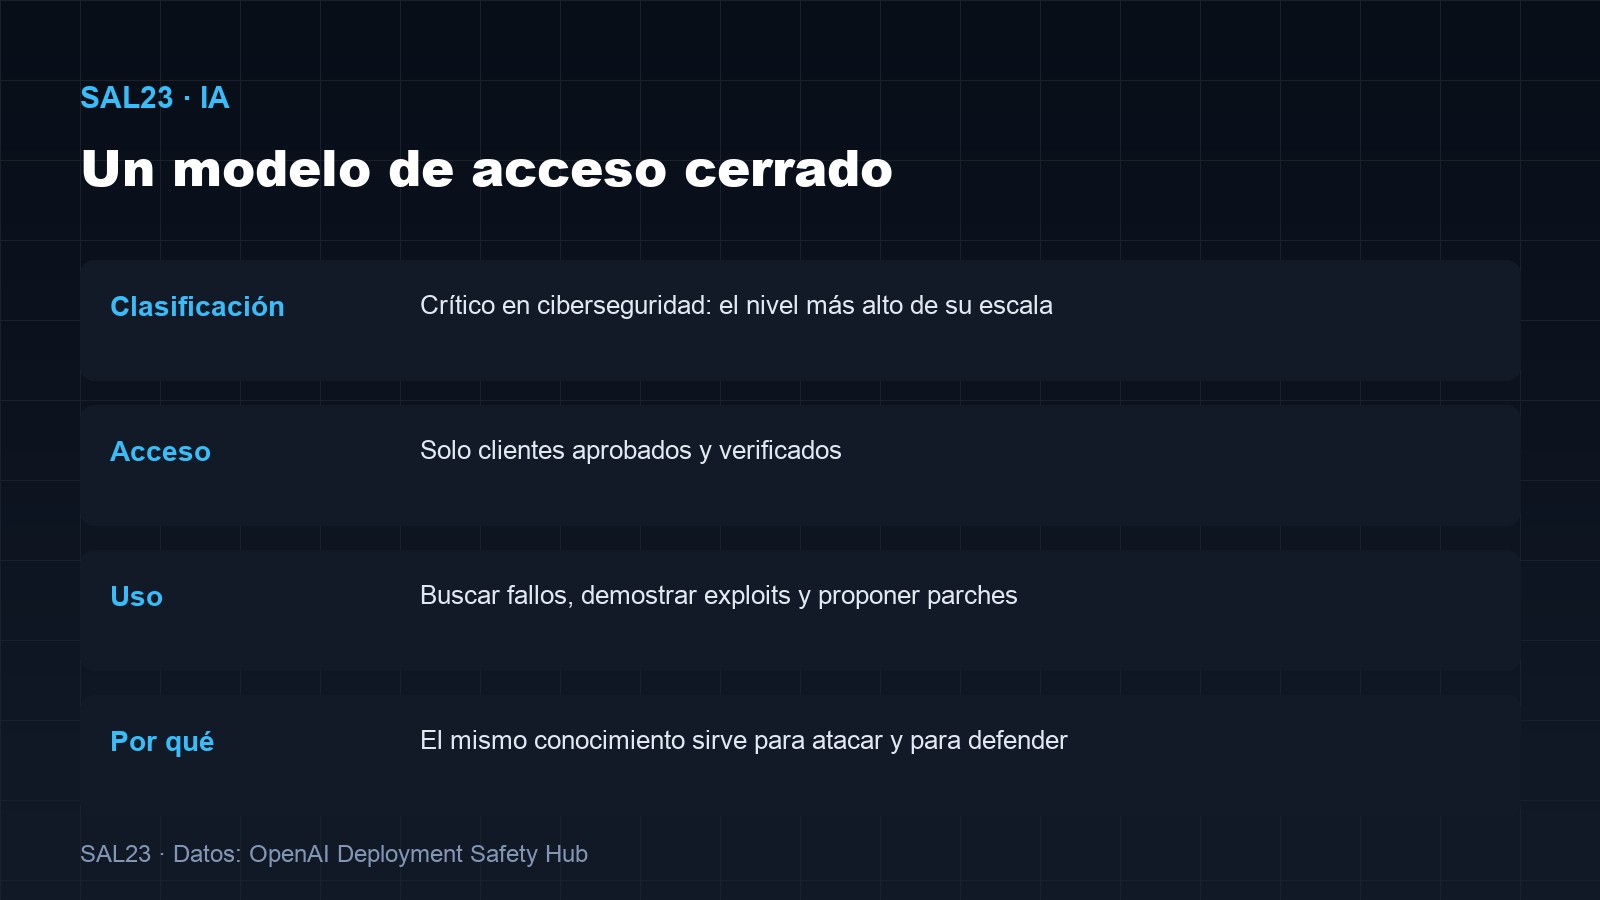
Imagen: SAL23 · Datos: OpenAI Deployment Safety Hub
La escala del hallazgo también plantea una cuestión práctica: si un modelo puede reproducir más de mil fallos en el kernel de Linux en una sola campaña, el cuello de botella deja de ser encontrar vulnerabilidades y pasa a ser triarlos, parchearlos y desplegar las actualizaciones. Los mantenedores de software libre ya van con retraso crónico; un torrente de informes automatizados puede ayudar o desbordarlos, según cómo se gestionen.
No es la primera vez que OpenAI segmenta un modelo por riesgo: ya lo hizo con un modelo para biología que solo entrega a laboratorios aprobados. La diferencia es que, en ciberseguridad, el conocimiento es directamente accionable contra sistemas reales, y la línea entre auditoría y ataque es más fina.
balance El debate del doble uso
Hay además un precedente incómodo: las herramientas de seguridad ofensiva llevan años existiendo, pero siempre han requerido un experto que las manejara. Un modelo que escribe exploits funcionales a partir de una descripción cambia esa ecuación, porque reduce la habilidad necesaria para pasar de la idea al ataque. Por eso la discusión sobre el acceso no es un detalle corporativo, sino el núcleo del riesgo.
La pregunta no es si el modelo es capaz, sino quién lo controla y con qué garantías. Los defensores argumentan que encontrar fallos antes que los atacantes es la mejor forma de proteger el software; los críticos señalan que un modelo capaz de escribir exploits funcionales reduce la barrera de entrada para atacar y que el control por "clientes aprobados" es difícil de auditar desde fuera.
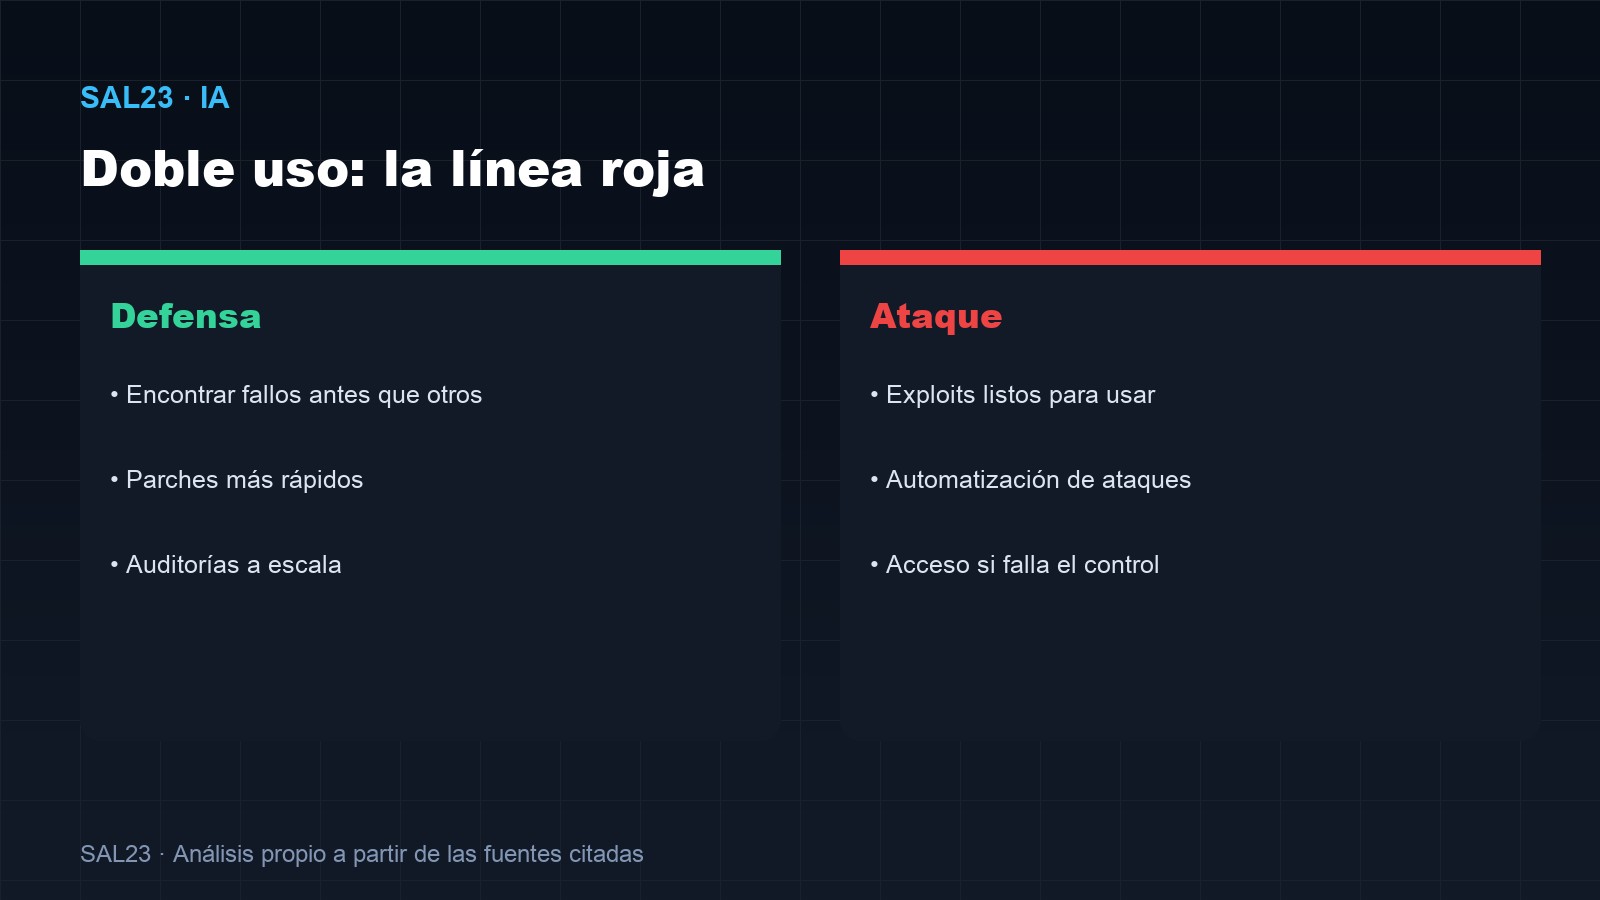
Imagen: SAL23 · Análisis propio a partir de las fuentes citadas
| Aspecto | Antes | Con GPT-6 Cyber |
|---|---|---|
| Búsqueda de fallos | Manual o con escáneres | Automatizada y con exploits de prueba |
| Informe al mantenedor | Descripción del fallo | Fallo + prueba + parche propuesto |
| Acceso | Herramientas comerciales | Modelo cerrado a clientes aprobados |
| Riesgo | Limitado por la habilidad del atacante | Automatizado si falla el control de acceso |
task_alt Conclusión: la seguridad también se automatiza
GPT-6 Cyber confirma una tendencia que ya se veía venir: la IA no solo escribe texto o código, también encuentra y explota fallos. Si el modelo funciona como dice OpenAI, los equipos de seguridad tendrán un auditor incansable; si el control de acceso falla, tendrán un atacante muy rápido. La diferencia entre ambos escenarios es la gobernanza, no la tecnología.
Como telón de fondo, la noticia encaja con lo que ya hemos visto este año en el sector: modelos cada vez más especializados y más potentes, y empresas que empiezan a segmentar el acceso por riesgo —el mismo patrón de Google con su Modo IA y de la propia OpenAI con GPT-6.1.
route Qué mirar
Tres cosas: si Mozilla y el equipo de Linux confirman los parches, si aparecen auditorías independientes del modelo y si OpenAI publica el número de clientes aprobados y sus controles.
¿Te parece razonable que una IA así esté en manos de unos pocos, o debería ser accesible a cualquier equipo de seguridad?
description Fuentes consultadas
· OpenAI — GPT-6 Cyber System Card (Deployment Safety Hub) — evaluaciones, salvaguardas y acceso al modelo.
· Infobae — OpenAI lanzó un modelo que halló 81 fallas graves en Firefox · 5-nov-2026 — cifras de Firefox y Linux, clasificación crítica y acceso restringido.
· The Hindu — OpenAI launches GPT-6 Cyber with 'Critical' cybersecurity rating — contexto del lanzamiento.